
MTTR vs MTBF: wzory, przykłady i benchmarki dla utrzymania ruchu

Gabriela Gic-Grusza
MTTR i MTBF to dwie podstawowe metryki utrzymania ruchu i inżynierii niezawodności. MTTR pokazuje, jak szybko organizacja przywraca sprawność po awarii. MTBF pokazuje, jak długo urządzenie pracuje między awariami. Razem pozwalają ocenić dostępność aktywa i skuteczność utrzymania ruchu.
Najprościej: MTTR należy skracać, a MTBF wydłużać. Niski MTTR oznacza sprawną reakcję, dobrą diagnostykę, dostępne części i skuteczne procedury naprawcze. Wysoki MTBF oznacza większą niezawodność, mniej awarii i lepiej dobraną strategię utrzymania ruchu.
Co to jest MTTR?
MTTR, czyli średni czas naprawy (Mean Time to Repair), to średni czas potrzebny na przywrócenie sprawności urządzenia po awarii.
W kontekście utrzymania ruchu MTTR mierzy naprawialność aktywa: jak szybko zespół potrafi wykryć problem, zdiagnozować przyczynę, zorganizować części, wykonać naprawę, przetestować urządzenie i oddać je do pracy.
Wzór:
MTTR = całkowity czas napraw / liczba napraw
Przykład:
MTTR = 10 h / 5 napraw = 2 h
Oznacza to, że średni czas jednej naprawy wynosi 2 godziny.
MTTR najczęściej wyraża się w godzinach. W systemach krytycznych, liniach o wysokiej automatyzacji albo procesach ciągłych może być liczony w minutach.
Co wchodzi do czasu naprawy?
W praktyce MTTR nie obejmuje wyłącznie fizycznej wymiany części. Czas naprawy może składać się z kilku etapów:
- wykrycie awarii;
- potwierdzenie zgłoszenia;
- diagnostyka;
- lokalizacja przyczyny;
- oczekiwanie na technika;
- oczekiwanie na części;
- przygotowanie narzędzi;
- wykonanie naprawy;
- testy po naprawie;
- walidacja pracy urządzenia;
- przekazanie maszyny do produkcji.
Dlatego samo „szybkie wykonanie naprawy” nie zawsze wystarczy, aby obniżyć MTTR. Jeżeli zespół długo diagnozuje problem, nie ma części w magazynie albo musi czekać na zgodę produkcji, MTTR będzie wysoki mimo sprawnych techników.
MTTR jako Mean Time to Repair, Recovery i Respond
Skrót MTTR bywa używany w kilku znaczeniach. W utrzymaniu ruchu najczęściej oznacza średni czas naprawy (Mean Time to Repair). W IT i zarządzaniu incydentami może oznaczać również średni czas przywrócenia (Mean Time to Recovery) albo średni czas reakcji (Mean Time to Respond).
W tym artykule MTTR rozumiemy głównie jako Mean Time to Repair w kontekście produkcji, maszyn i przemysłowego utrzymania ruchu. Kontekst IT jest pokrewny, ale nie jest głównym zakresem artykułu.
Co to jest MTBF?
MTBF, czyli średni czas między awariami (Mean Time Between Failures), to średni czas pracy urządzenia między kolejnymi awariami. Warto tutaj nadminić, że skrót MTBF bardzo często bywa błędnie rozwijany jako Mean Time Before Failures, a więc średni czas przed awarią, a jego prawidłowe rozwinięcie to Mean Time Between Failures, a więc średni czas między awariami.
MTBF mierzy niezawodność aktywa: jak długo urządzenie działa w normalnych warunkach pracy, zanim wystąpi kolejna awaria. Im wyższy MTBF, tym rzadziej urządzenie ulega awarii.
Wzór:
MTBF = całkowity czas pracy / liczba awarii
Przykład:
MTBF = 1000 h / 5 awarii = 200 h
Oznacza to, że urządzenie pracuje średnio 200 godzin między awariami.
MTBF należy liczyć na podstawie czasu pracy, a nie samego czasu kalendarzowego. Jeżeli maszyna była zatrzymana, nie produkowała albo była wyłączona poza planem, trzeba uważać, aby nie zawyżyć metryki przez błędny dobór mianownika.
Co mierzy MTBF?
MTBF pokazuje, jak często aktywo zawodzi. Jest metryką niezawodności i pomaga odpowiedzieć na pytania:
- które maszyny psują się najczęściej;
- czy awaryjność rośnie, czy spada;
- czy program utrzymania prewencyjnego działa;
- które aktywa wymagają analizy przyczyn źródłowych;
- gdzie warto wdrożyć monitoring stanu;
- które komponenty mają najgorszą historię pracy;
- czy modernizacja lub zmiana konstrukcyjna przynosi efekt.
MTBF jest szczególnie przydatny dla systemów naprawialnych, takich jak pompy, silniki, przenośniki, linie pakujące, sprężarki, roboty, maszyny CNC albo instalacje procesowe.
MTTR vs MTBF – najważniejsze różnice
MTTR i MTBF mierzą różne aspekty niezawodności. MTTR opisuje, jak szybko naprawiamy. MTBF opisuje, jak rzadko dochodzi do awarii.
| Wymiar | MTTR | MTBF |
| Pełna nazwa | Średni czas naprawy (Mean Time to Repair) | Średni czas między awariami (Mean Time Between Failures) |
| Co mierzy | Naprawialność, czyli szybkość przywracania sprawności | Niezawodność, czyli częstotliwość awarii |
| Wzór | Całkowity czas napraw / liczba napraw | Całkowity czas pracy / liczba awarii |
| Jednostka | Godziny lub minuty (czas naprawy) | Godziny pracy |
| Cel | Minimalizować | Maksymalizować |
| Poprawa oznacza | Lepszą diagnostykę, części, procedury i kompetencje | Mniej awarii, lepszą prewencję, RCA, monitoring i RCM |
| Typowy zakres | <1 h bardzo dobrze, 1–4 h przeciętnie, >8 h problematycznie | Silnie zależny od branży i typu sprzętu |
| Dane źródłowe | Zlecenia pracy, czasy napraw, logi serwisowe | Historia awarii, czas pracy, logi operacyjne |
| Powiązany KPI | Efektywność utrzymania ruchu | Niezawodność aktywów |
| Wpływ na dostępność | Niższy MTTR zwiększa dostępność | Wyższy MTBF zwiększa dostępność |
Nie należy traktować tych metryk konkurencyjnie. Dobre utrzymanie ruchu potrzebuje obu. Można mieć wysoki MTBF, ale jeżeli każda awaria trwa bardzo długo, dostępność nadal będzie problemem. Można też mieć niski MTTR, ale jeżeli maszyna psuje się co kilka godzin, organizacja będzie stale pracować w trybie reaktywnym.
Jak obliczyć MTTR krok po kroku?
MTTR obliczamy, sumując czas wszystkich napraw i dzieląc go przez liczbę napraw w analizowanym okresie.
Przykład: maszyna pakująca miała w miesiącu 4 awarie. Czasy napraw wyniosły:
| Awaria | Czas naprawy |
| 1 | 1,5 h |
| 2 | 2,0 h |
| 3 | 0,5 h |
| 4 | 3,0 h |
Krok 1: zsumuj czasy napraw.
1,5 h + 2,0 h + 0,5 h + 3,0 h = 7,0 h
Krok 2: podziel całkowity czas napraw przez liczbę napraw.
MTTR = 7,0 h / 4 = 1,75 h
Krok 3: zinterpretuj wynik.
Średnia naprawa trwa 1 godzinę i 45 minut.
Taki wynik może być dobry albo przeciętny w zależności od branży, krytyczności aktywa i typu awarii. Dla prostej maszyny pomocniczej 1,75 h może być akceptowalne. Dla linii krytycznej, która zatrzymuje cały zakład, może być zbyt długo.
Jak obliczyć MTBF krok po kroku?
MTBF obliczamy, dzieląc całkowity czas pracy urządzenia przez liczbę awarii w analizowanym okresie.
Przykład: ta sama maszyna pakująca była w miesiącu zaplanowana do pracy przez 720 godzin (praca ciągła 24/7). Wystąpiły 4 awarie, a łączny czas napraw wyniósł 7 godzin.
Krok 1: oblicz czas pracy.
Czas pracy = 720 h – 7 h = 713 h
Krok 2: podziel czas pracy przez liczbę awarii.
MTBF = 713 h / 4 = 178,25 h
Krok 3: zinterpretuj wynik.
Maszyna pracuje średnio 178,25 godziny, czyli około 7,4 doby, między awariami.
Warto analizować MTBF w czasie. Pojedynczy wynik miesięczny może być zaburzony przez nietypowe zdarzenie. Trend kwartalny lub roczny lepiej pokazuje, czy niezawodność aktywa rzeczywiście się poprawia.
Jak MTTR i MTBF wpływają na dostępność?
MTTR i MTBF razem pozwalają obliczyć dostępność aktywa. Dostępność rośnie, gdy MTBF jest wyższy, a MTTR niższy.
Wzór:
Dostępność = MTBF / (MTBF + MTTR)
Dla danych z wcześniejszego przykładu:
- MTBF = 178,25 h;
- MTTR = 1,75 h.
Obliczenie:
Dostępność = 178,25 / (178,25 + 1,75)
Dostępność = 178,25 / 180 = 0,9903 = 99,03%
Interpretacja:
Urządzenie było dostępne przez około 99,03% czasu wynikającego z relacji między średnim czasem pracy między awariami a średnim czasem naprawy.
Dostępność jest pierwszym komponentem OEE, czyli całkowitej efektywności wyposażenia (Overall Equipment Effectiveness). MTTR i MTBF nie zastępują pełnej analizy OEE, ale bezpośrednio wpływają na dostępność maszyn, linii i procesów.
MTBF, MTTF, MTTD i MTTA – rodzina metryk niezawodności
MTTR i MTBF są najczęściej stosowane w utrzymaniu ruchu, ale warto rozumieć całą rodzinę metryk „mean time”. Pomaga to uniknąć błędów w interpretacji danych.
| Metryka | Pełna nazwa | Dotyczy | Co mierzy | Wzór |
| MTTR | Średni czas naprawy (Mean Time to Repair) | Systemy naprawialne | Naprawialność | Całkowity czas napraw / liczba napraw |
| MTBF | Średni czas między awariami (Mean Time Between Failures) | Systemy naprawialne | Niezawodność | Całkowity czas pracy / liczba awarii |
| MTTF | Średni czas do awarii (Mean Time to Failure) | Elementy nienaprawialne | Niezawodność do momentu wymiany | Całkowity czas pracy / liczba uszkodzonych (wymienionych) jednostek |
| MTTD | Średni czas wykrycia (Mean Time to Detect) | Wszystkie systemy | Szybkość wykrycia problemu | Całkowity czas wykrywania / liczba awarii |
| MTTA | Średni czas potwierdzenia (Mean Time to Acknowledge) | Zarządzanie incydentami | Szybkość reakcji na zgłoszenie | Całkowity czas potwierdzenia / liczba incydentów |
MTBF vs MTTF
MTBF stosuje się do systemów naprawialnych. MTTF stosuje się do elementów nienaprawialnych, które po uszkodzeniu są wymieniane, a nie naprawiane.
Przykład:
- pompa, silnik lub sprężarka – zwykle MTBF;
- żarówka, prosty czujnik jednorazowy, część wymieniana po uszkodzeniu – częściej MTTF.
Częstym błędem jest używanie MTBF i MTTF zamiennie. W praktyce prowadzi to do błędnych wniosków, zwłaszcza przy porównywaniu komponentów elektronicznych, części eksploatacyjnych i maszyn naprawialnych.
MTTD jako część cyklu naprawy
MTTD, czyli średni czas wykrycia (Mean Time to Detect), mierzy czas od wystąpienia awarii do jej wykrycia. Jest częścią całkowitego cyklu przywracania sprawności.
Jeżeli awaria zostaje wykryta późno, całkowity MTTR zwykle rośnie. Dlatego monitoring stanu, alarmy, obchody operatorskie i analiza danych mogą obniżać MTTD, a pośrednio również MTTR.
MTBF a wskaźnik awaryjności
Wskaźnik awaryjności, oznaczany często jako λ, jest odwrotnością MTBF.
Wzór:
λ = 1 / MTBF
Jeżeli MTBF wynosi 200 godzin, to:
λ = 1 / 200 = 0,005 awarii na godzinę
Taka relacja jest użyteczna w inżynierii niezawodności, ale wymaga ostrożności. Zależność ta jest ścisła tylko przy założeniu stałej intensywności uszkodzeń (rozkład wykładniczy), co nie zawsze odpowiada rzeczywistemu cyklowi życia maszyny. Urządzenie może mieć wyższą awaryjność na początku eksploatacji, stabilny okres pracy, a później rosnącą awaryjność wskutek zużycia. Ten przebieg często opisuje się jako krzywą wannową (bathtub curve).
Dlatego MTBF jest przydatną metryką, ale nie powinien być jedyną podstawą decyzji o strategii utrzymania.
Jakie wartości MTTR i MTBF są dobre?
Dobre wartości MTTR i MTBF zależą od branży, typu urządzenia, wieku aktywa, krytyczności, modelu pracy i kosztu przestoju. Nie ma jednej uniwersalnej wartości, która byłaby właściwa dla każdego zakładu.
| Branża / typ wyposażenia | Typowy MTBF | Docelowy MTTR | Uwagi |
| Produkcja ogólna | 200–1000 h | <2 h | Silnie zależy od wieku i typu wyposażenia |
| Montaż w motoryzacji | 500–2000 h | <1 h | Wysokie wymagania dostępności i takt produkcji |
| Przemysł procesowy / chemiczny | 1000–5000 h | <4 h | Praca ciągła, duży koszt zatrzymania |
| Przemysł spożywczy i napojowy | 300–800 h | <1,5 h | Wymogi higieniczne i częste cykle mycia |
| Energetyka | 2000–8000 h | <2 h | Aktywa krytyczne i wysokie wymagania bezpieczeństwa |
| Elektronika – specyfikacje komponentów | 50 000–200 000 h | Nie dotyczy | Często bardziej adekwatny jest MTTF |
| Farmacja / branże regulowane | 500–2000 h | <1 h | Wymogi GMP, walidacja i zgodność |
Wartości benchmarkowe powinny być traktowane jako orientacyjne. Najważniejsze jest porównanie aktywów w podobnym kontekście: podobna technologia, obciążenie, wiek, warunki pracy, tryb produkcji i krytyczność.
Dla wielu organizacji ważniejszy od jednorazowej wartości jest trend. Jeżeli MTTR spada, a MTBF rośnie, organizacja zwykle poprawia zarówno naprawialność, jak i niezawodność. Jeżeli MTTR spada, ale MTBF również spada, zespół naprawia szybciej, ale awarie występują częściej.
Jak obniżyć MTTR?
MTTR obniża się przez skrócenie czasu wykrycia, diagnozy, oczekiwania na części, samej naprawy i walidacji po naprawie.
Najważniejsze działania:
| Obszar | Co zrobić | Wpływ na MTTR |
| Części zamienne | Zdefiniować części krytyczne, poziomy min/max i lokalizację części | Krótsze oczekiwanie na materiały |
| Procedury naprawcze | Przygotować standardowe procedury operacyjne i instrukcje napraw | Szybsza diagnoza i wykonanie |
| Szkolenia | Budować macierz kompetencji i prowadzić szkolenia międzydziedzinowe (cross-training) | Mniejsza zależność od pojedynczych ekspertów |
| Diagnostyka | Wykorzystywać kody błędów, analizę drgań, termografię i dane procesowe | Szybsza lokalizacja przyczyny |
| CMMS | Automatyzować zlecenia, historię napraw i powiązanie części z aktywem | Mniej pracy administracyjnej i lepsza historia |
| Monitoring stanu | Wcześniej wykrywać degradację i alarmować zespół | Krótszy MTTD i lepsze przygotowanie naprawy |
| Organizacja pracy | Ustalić eskalację, priorytety i dostępność techników | Szybsza reakcja na awarie krytyczne |
| Walidacja | Standaryzować testy po naprawie | Krótsze i pewniejsze przywrócenie do produkcji |
Niski MTTR nie powinien oznaczać napraw „na skróty”. Celem jest szybsze i skuteczne przywrócenie funkcji, bez zwiększania ryzyka powtórnej awarii.
Jak poprawić MTBF?
MTBF poprawia się przez zmniejszenie częstotliwości awarii. Oznacza to przejście od samego reagowania do eliminowania źródeł problemów.
Najważniejsze działania:
| Obszar | Co zrobić | Wpływ na MTBF |
| Utrzymanie prewencyjne | Zaplanować inspekcje, smarowanie, regulacje i wymiany | Mniej awarii wynikających z zaniedbania |
| Autonomiczne utrzymanie ruchu | Włączyć operatorów w codzienną kontrolę i czyszczenie | Wcześniejsze wykrywanie odchyleń |
| Analiza przyczyn źródłowych | Badać awarie powtarzalne i usuwać przyczyny, nie objawy | Trwała redukcja powtarzalnych awarii |
| Monitoring stanu | Obserwować drgania, temperaturę, olej, prąd i inne sygnały | Wykrywanie degradacji przed awarią |
| RCM | Dobierać strategię UR według funkcji, trybu awarii i konsekwencji | Lepsze dopasowanie działań do krytyczności |
| Modernizacja | Zmieniać konstrukcję lub komponenty przy chronicznych awariach | Usuwanie słabych punktów technicznych |
| Analityka danych | Analizować wzorce awarii, sezony, obciążenia i warunki pracy | Lepsze decyzje o prewencji i inwestycjach |
Wysoki MTBF jest efektem systemu, a nie pojedynczej akcji. Wymaga danych, dyscypliny eksploatacyjnej, właściwych przeglądów, dbałości operatorskiej (operator care), jakości części i konsekwentnego zamykania działań po analizie awarii.
Skąd brać dane do MTTR i MTBF?
Najczęściej źródłem danych do obliczania MTTR i MTBF jest CMMS, czyli system komputerowego zarządzania utrzymaniem ruchu (Computerized Maintenance Management System). Dane mogą też pochodzić z historianów, systemów SCADA, MES, ERP, systemów produkcyjnych i platform danych przemysłowych.
Minimalny zestaw danych do obliczeń:
| Dane | Potrzebne do | Przykład |
| Identyfikator aktywa | MTTR, MTBF | Pompa P-101, linia L2, pakowarka PK-04 |
| Czas wystąpienia awarii | MTBF, MTTD | 2026-09-18 08:35 |
| Czas rozpoczęcia naprawy | MTTR, MTTA | 2026-09-18 09:05 |
| Czas zakończenia naprawy | MTTR | 2026-09-18 10:20 |
| Czas przywrócenia do pracy | MTTR / Recovery | 2026-09-18 10:35 |
| Czas pracy urządzenia | MTBF | 713 h w miesiącu |
| Tryb awarii | Analiza niezawodności | Łożysko, napęd, czujnik, układ pneumatyczny |
| Przyczyna awarii | RCA, MTBF | Brak smarowania, niewspółosiowość, zanieczyszczenie |
| Części użyte | MTTR, koszty | Łożysko, pas, czujnik |
| Technik / zespół | MTTR, kompetencje | Zmiana A, automatyk, mechanik |
Jakość danych jest krytyczna. Jeżeli zlecenia są zamykane po czasie, awarie są opisywane ogólnie jako „usterka”, a czas rozpoczęcia naprawy nie jest rejestrowany, MTTR i MTBF będą mało wiarygodne.
Zasada jest prosta: niepoprawne dane wejściowe dają niepoprawne KPI. Automatyzacja obliczeń ma sens dopiero wtedy, gdy organizacja uporządkuje definicje awarii, czasów, statusów i kodów przyczyn.
MTTR i MTBF w Excelu – jak przygotować prosty arkusz?
MTTR i MTBF można policzyć w Excelu, jeżeli dane są uporządkowane. Arkusz powinien mieć kolumny pozwalające odtworzyć czas awarii, czas naprawy i czas pracy aktywa.
Przykładowa struktura:
| Kolumna | Opis |
| Asset ID | Identyfikator maszyny lub komponentu |
| Failure start | Czas wystąpienia awarii |
| Repair start | Czas rozpoczęcia naprawy |
| Repair end | Czas zakończenia naprawy |
| Restore time | Czas przywrócenia do pracy |
| Repair duration | Repair end – Repair start lub Restore time – Failure start, zależnie od definicji |
| Failure mode | Tryb awarii |
| Root cause | Przyczyna źródłowa |
| Operating hours | Czas pracy aktywa w okresie |
| Period | Miesiąc, tydzień, kwartał |
Dla MTTR w Excelu należy zsumować czasy napraw i podzielić przez liczbę napraw. Dla MTBF należy zsumować czas pracy i podzielić przez liczbę awarii. Kluczowe jest konsekwentne stosowanie tej samej definicji czasu naprawy i czasu pracy.
Excel może wystarczyć na początku, ale przy wielu aktywach, zmianach, zakładach i źródłach danych lepiej przenieść kalkulację do CMMS, platformy danych lub dashboardu analitycznego.
Smart RDM w kontekście MTTR i MTBF
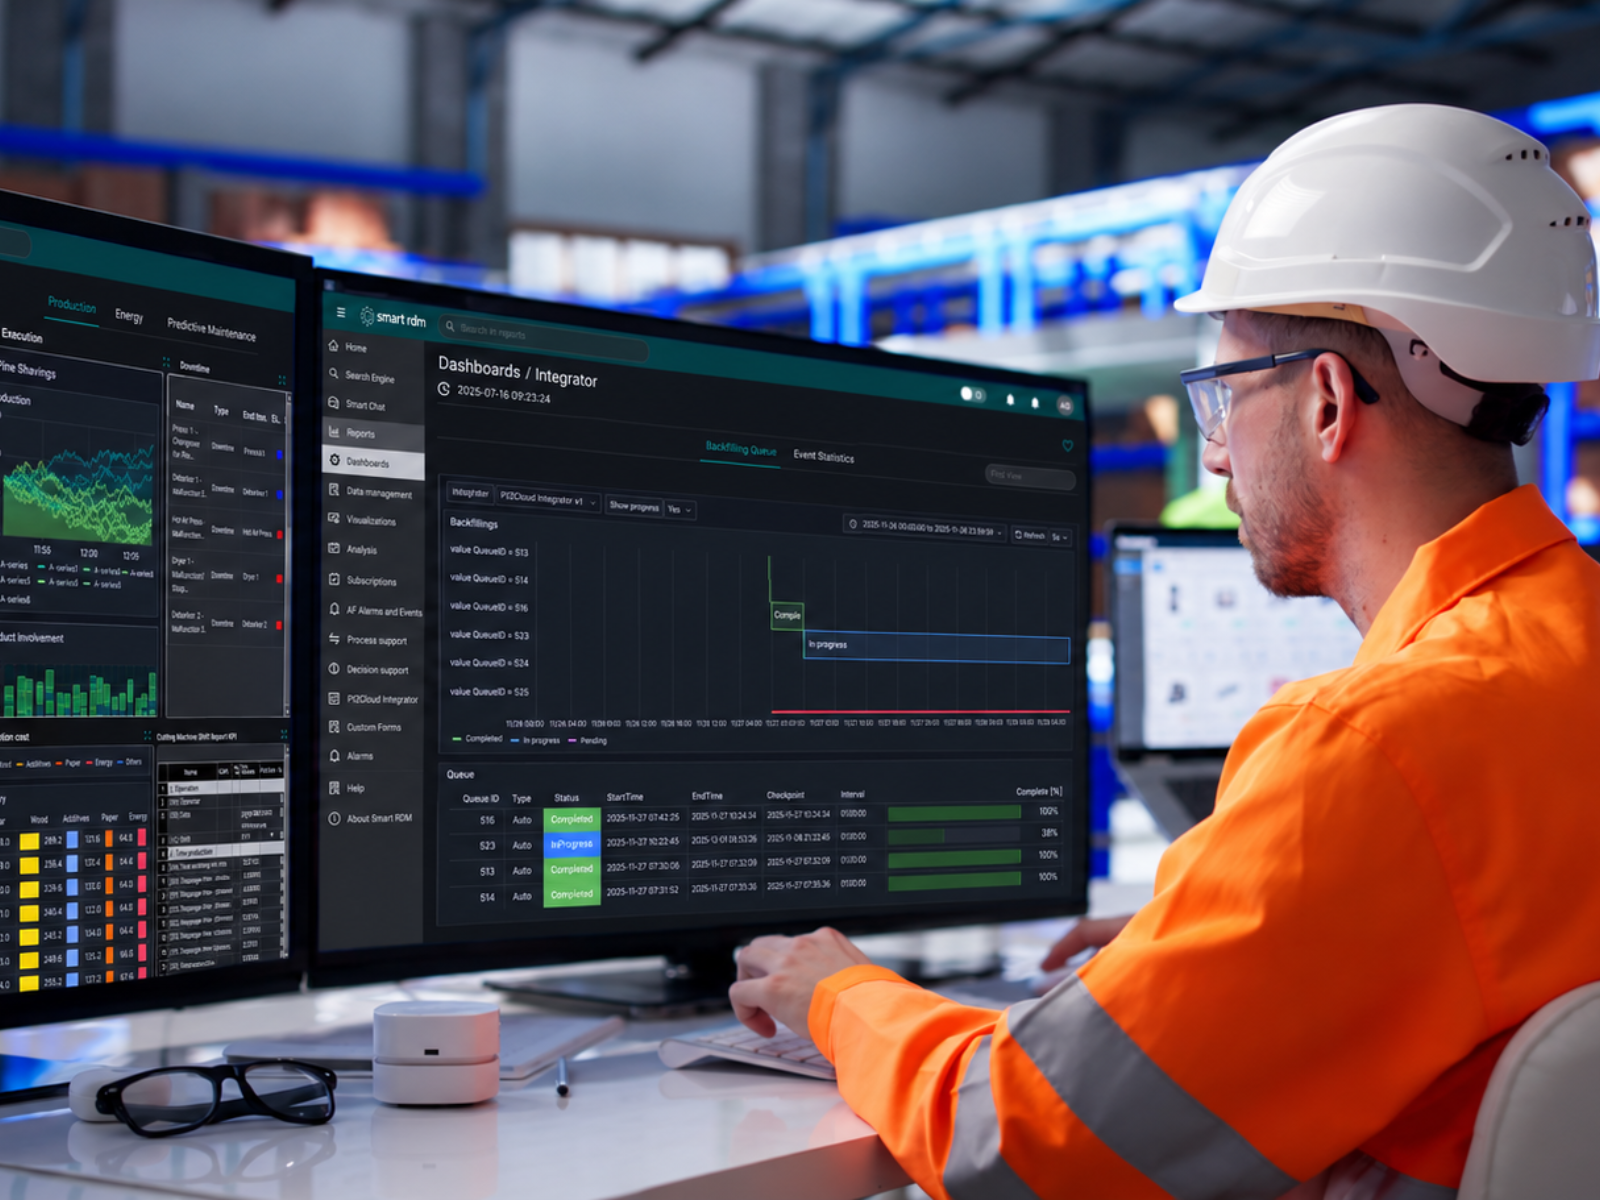
Smart RDM może wspierać obliczanie i analizę MTTR oraz MTBF jako platforma danych przemysłowych i analityki operacyjnej.
W praktyce wartość platformy polega na łączeniu danych z różnych źródeł:
- zdarzeń awaryjnych;
- zleceń utrzymania ruchu;
- danych produkcyjnych;
- statusów maszyn;
- sygnałów z systemów SCADA;
- danych z historianów;
- alarmów;
- danych energetycznych;
- danych jakościowych;
- informacji o częściach i działaniach serwisowych.
Dzięki temu MTTR i MTBF mogą być liczone bardziej automatycznie i analizowane w kontekście aktywa, linii, zmiany, typu awarii, produkcji i kosztów. Zespół utrzymania ruchu nie widzi wtedy tylko liczby, ale może sprawdzić, które maszyny mają najgorsze trendy, które awarie wracają i gdzie opóźnienie wynika z diagnostyki, części albo organizacji pracy.
Smart RDM nie zastępuje samej strategii utrzymania ruchu. Może jednak dostarczać dane i analitykę potrzebne do lepszych decyzji: które aktywa analizować, gdzie wdrożyć monitoring stanu, gdzie zmienić plan PM, gdzie wykonać RCA i które działania faktycznie poprawiają dostępność.
Przegląd narzędzi i źródeł 2026
Rynek narzędzi związanych z MTTR i MTBF obejmuje systemy CMMS, platformy EAM, narzędzia monitoringu IT, systemy zarządzania incydentami oraz platformy danych przemysłowych. Poniższa tabela ma charakter neutralny i nie jest rankingiem.
| Narzędzie / dostawca | Charakterystyka |
| IBM Maximo | Platforma EAM do zarządzania aktywami, zleceniami, historią utrzymania ruchu i analizą wskaźników niezawodności |
| Atlassian | Narzędzia incident management używane głównie w kontekście IT/DevOps, gdzie MTTR oznacza często czas odzyskania lub reakcji |
| LogicMonitor | Platforma monitoringu infrastruktury IT, wykorzystująca metryki MTTR, MTTD i MTBF w kontekście dostępności systemów |
| eMaint / Fluke | System CMMS wspierający zlecenia pracy, historię napraw i KPI utrzymania ruchu, w tym MTTR i MTBF |
| MaintainX | Mobilny CMMS do obsługi zleceń, pracy techników i raportowania wskaźników utrzymania ruchu |
| Smart RDM | Platforma danych przemysłowych wspierająca łączenie danych produkcyjnych, maintenance i operacyjnych do analizy MTTR, MTBF i dostępności |
Wybór narzędzia zależy od kontekstu. Inne potrzeby ma zespół IT zarządzający incydentami, inne zakład produkcyjny liczący awarie maszyn, a jeszcze inne grupa przemysłowa porównująca metryki między zakładami.
Najczęstsze błędy w obliczaniu MTTR i MTBF
Najczęstsze błędy wynikają z niespójnych definicji, złej jakości danych i mieszania różnych typów zdarzeń.
Typowe problemy:
- liczenie czasu kalendarzowego zamiast czasu pracy;
- mieszanie awarii krytycznych i drobnych usterek bez klasyfikacji;
- niejasna definicja początku awarii;
- niejasna definicja końca naprawy;
- liczenie oczekiwania na produkcję jako naprawy bez rozróżnienia;
- nieuwzględnianie awarii powtarzalnych;
- zamykanie zleceń z opóźnieniem;
- brak kodów przyczyn;
- brak powiązania z aktywem;
- używanie MTBF dla elementów nienaprawialnych zamiast MTTF;
- porównywanie maszyn o różnej krytyczności i obciążeniu;
- analizowanie średniej bez rozkładu i trendu;
- traktowanie wysokiego MTBF jako gwarancji braku awarii;
- raportowanie KPI bez działań korygujących.
Dobra praktyka polega na tym, aby przed raportowaniem ustalić definicje: co jest awarią, kiedy zaczyna się naprawa, kiedy kończy się przywrócenie funkcji, co zaliczamy do czasu pracy i które zdarzenia wykluczamy z obliczeń.
Jak używać MTTR i MTBF w decyzjach utrzymania ruchu?
MTTR i MTBF powinny prowadzić do decyzji, a nie tylko do raportu.
Przykłady interpretacji:
| Sytuacja | Możliwy wniosek | Działanie |
| Niski MTTR, niski MTBF | Szybko naprawiamy, ale awarie są częste | RCA, RCM, monitoring stanu, poprawa PM |
| Wysoki MTTR, wysoki MTBF | Awarie są rzadkie, ale naprawy trwają długo | Części krytyczne, procedury, szkolenie, diagnostyka |
| Wysoki MTTR, niski MTBF | Maszyna jest problematyczna i trudna do przywrócenia | Priorytetowa analiza, modernizacja, zmiana strategii |
| Niski MTTR, wysoki MTBF | Dobra naprawialność i dobra niezawodność | Utrzymać standard, monitorować trend |
| MTTR rośnie | Naprawy stają się trudniejsze lub gorzej zorganizowane | Sprawdzić części, kompetencje, procedury i dostępność techników |
| MTBF spada | Awarii jest coraz więcej | Sprawdzić przyczyny źródłowe, obciążenie, warunki pracy i plan PM |
Warto analizować MTTR i MTBF razem z kosztem przestoju, krytycznością aktywa, dostępnością części, OEE, powtarzalnością awarii i wpływem na produkcję. Sama średnia nie pokaże pełnego obrazu.
FAQ
Co to jest MTTR?
MTTR, czyli średni czas naprawy (Mean Time to Repair), to średni czas potrzebny na przywrócenie sprawności urządzenia po awarii.
Wzór to: MTTR = całkowity czas napraw / liczba napraw. Metryka pokazuje, jak szybko organizacja potrafi diagnozować i usuwać awarie.
Co oznacza MTTR?
MTTR najczęściej oznacza Mean Time to Repair, czyli średni czas naprawy.
W innych kontekstach, zwłaszcza IT, może oznaczać również Mean Time to Recovery albo Mean Time to Respond. W utrzymaniu ruchu najważniejsze znaczenie to czas naprawy aktywa od awarii do przywrócenia funkcji.
Co to jest MTBF?
MTBF, czyli średni czas między awariami (Mean Time Between Failures), to średni czas pracy urządzenia między kolejnymi awariami.
Wzór to: MTBF = całkowity czas pracy / liczba awarii. Metryka pokazuje niezawodność systemu naprawialnego.
Co oznacza MTBF?
MTBF oznacza Mean Time Between Failures, czyli średni czas między awariami.
Stosuje się go dla systemów naprawialnych, takich jak maszyny, linie, pompy, silniki, sprężarki albo instalacje procesowe.
Jaka jest różnica między MTTR a MTBF?
MTTR mierzy naprawialność, czyli jak szybko przywracamy sprawność po awarii. MTBF mierzy niezawodność, czyli jak długo urządzenie pracuje między awariami.
MTTR powinien być jak najniższy, a MTBF jak najwyższy. Oba wskaźniki razem wpływają na dostępność aktywa.
Jak obliczyć MTTR?
Aby obliczyć MTTR, zsumuj czas wszystkich napraw i podziel przez liczbę napraw.
Przykład: cztery naprawy trwały 1,5 h, 2,0 h, 0,5 h i 3,0 h. Suma to 7 h. MTTR = 7 h / 4 = 1,75 h.
Jak obliczyć MTBF?
Aby obliczyć MTBF, podziel całkowity czas pracy przez liczbę awarii.
Przykład: maszyna pracowała 713 godzin i miała 4 awarie. MTBF = 713 h / 4 = 178,25 h.
Jak MTTR i MTBF wpływają na dostępność?
Dostępność można policzyć ze wzoru: Dostępność = MTBF / (MTBF + MTTR).
Jeżeli MTBF wynosi 178,25 h, a MTTR 1,75 h, dostępność wynosi 178,25 / 180 = 99,03%. Wyższy MTBF i niższy MTTR zwiększają dostępność.
Co to jest dobry MTTR?
Dobry MTTR zależy od branży i krytyczności aktywa. W ogólnej produkcji wynik poniżej 2 godzin często można uznać za dobry punkt odniesienia, a poniżej 1 godziny za bardzo dobry dla wielu zastosowań.
Dla systemów krytycznych wymagania mogą być znacznie bardziej rygorystyczne.
Co to jest dobry MTBF?
Dobry MTBF zależy od typu urządzenia, branży, wieku aktywa i warunków pracy. W produkcji ogólnej wartości rzędu 200–1000 godzin mogą być typowe, a w automotive lub energetyce oczekiwania mogą być wyższe.
Najważniejszy jest trend oraz porównanie podobnych aktywów w podobnych warunkach.
Czym różni się MTBF od MTTF?
MTBF dotyczy systemów naprawialnych, które po awarii wracają do pracy. MTTF, czyli średni czas do awarii (Mean Time to Failure), dotyczy elementów nienaprawialnych, które po uszkodzeniu są wymieniane.
Przykład: dla pompy stosujemy MTBF, a dla prostej części wymienianej po awarii częściej MTTF.
Co to jest MTTD?
MTTD, czyli średni czas wykrycia (Mean Time to Detect), to średni czas od wystąpienia awarii do jej wykrycia.
MTTD jest częścią całego cyklu naprawy. Skrócenie MTTD przez monitoring, alarmy i obchody operatorskie może obniżyć MTTR.
Jak zmniejszyć MTTR?
MTTR można zmniejszyć przez lepszą diagnostykę, dostępność części krytycznych, standardowe procedury napraw, szkolenie techników, CMMS, monitoring stanu i lepszą organizację pracy.
Najważniejsze jest skracanie całego cyklu naprawy, a nie tylko fizycznego czasu wymiany części.
Jak poprawić MTBF?
MTBF można poprawić przez utrzymanie prewencyjne, autonomiczne utrzymanie ruchu, analizę przyczyn źródłowych, monitoring stanu, RCM, modernizacje techniczne i analizę danych o awariach.
Celem jest ograniczenie liczby awarii, a nie tylko szybsze ich usuwanie.
Jakie dane są potrzebne do obliczenia MTTR i MTBF?
Potrzebne są: identyfikator aktywa, czas wystąpienia awarii, czas rozpoczęcia i zakończenia naprawy, czas przywrócenia do pracy, czas pracy urządzenia, liczba awarii, tryb awarii, przyczyna i dane ze zleceń maintenance.
Najczęściej dane pochodzą z CMMS, systemów produkcyjnych, SCADA, historianów lub platformy danych przemysłowych.
Czy MTTR i MTBF są częścią OEE?
MTTR i MTBF nie są bezpośrednimi składnikami wzoru OEE, ale wpływają na dostępność, czyli pierwszy komponent OEE.
Mniej awarii i krótsze naprawy zwiększają dostępny czas pracy maszyny, a tym samym mogą poprawiać dostępność w OEE.
Czy MTTR ma znaczenie w IT?
Tak, MTTR jest także stosowany w IT, cyberbezpieczeństwie i zarządzaniu incydentami. W takim kontekście może oznaczać średni czas przywrócenia usługi albo średni czas reakcji.
Ten artykuł koncentruje się jednak na utrzymaniu ruchu i środowisku produkcyjnym.
Źródła
- Standardy i materiały dotyczące inżynierii niezawodności oraz metryk MTTR, MTBF, MTTF, MTTD i dostępności.
- Materiały branżowe dotyczące utrzymania ruchu, CMMS, niezawodności aktywów i KPI maintenance.
- Materiały dotyczące OEE i dostępności wyposażenia.
- Materiały dotyczące condition monitoring, RCM, RCA, autonomous maintenance i predictive maintenance.
- Materiały dotyczące danych z CMMS, jakości danych i automatyzacji raportowania wskaźników utrzymania ruchu.
- Materiały wewnętrzne Smart RDM dotyczące danych przemysłowych, analityki operacyjnej, monitorowania aktywów i wskaźników utrzymania ruchu.

Tryb jasny