
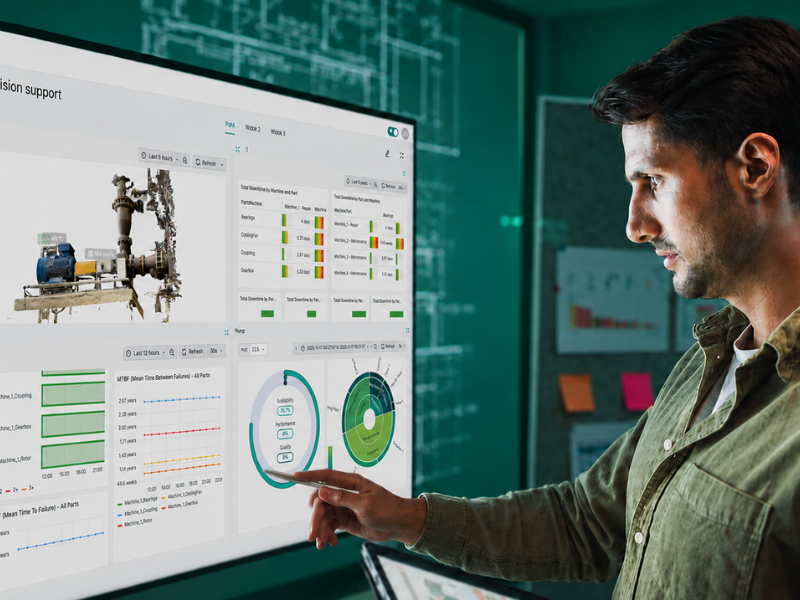
Czym jest predykcyjne utrzymanie ruchu (predictive maintenance)? Kompleksowy przewodnik.
Sebastian Dudzik
Predictive maintenance, czyli predykcyjne utrzymanie ruchu (określane również jako konserwacja predykcyjna lub utrzymanie predykcyjne), to strategia utrzymania ruchu oparta na danych, która wykorzystuje dane o stanie urządzeń, odczyty z sensorów oraz modele analityczne do przewidywania, kiedy dany zasób może ulec awarii lub wymagać serwisu. Zamiast utrzymywać urządzenia dopiero po awarii albo według stałych interwałów kalendarzowych, predictive maintenance pomaga zespołom działać zanim dojdzie do awarii funkcjonalnej.
W praktyce predictive maintenance odpowiada na jedno pytanie:
Jakie działania utrzymania ruchu należy wykonać, na którym zasobie i kiedy, na podstawie danych pochodzących z samego urządzenia?
To odróżnia predictive maintenance od tradycyjnego podejścia reaktywnego i prewencyjnego. Utrzymanie reaktywne polega na czekaniu na awarię. Utrzymanie prewencyjne działa według ustalonego harmonogramu. Utrzymanie oparte na stanie technicznym uruchamia działania wtedy, gdy mierzony parametr przekroczy określony próg. Predykcyjne utrzymanie ruchu idzie o krok dalej: wykorzystuje dane historyczne, bieżące dane o stanie maszyn oraz modele, aby oszacować przyszłe ryzyko awarii lub pozostały czas użytecznej pracy urządzenia.
IBM definiuje Predictive maintenance jako podejście rozwijające monitorowanie oparte na stanie technicznym, które polega na ciągłej ocenie kondycji urządzeń w czasie rzeczywistym w celu optymalizacji ich wydajności i żywotności. AWS opisuje je jako strategię służącą do szacowania i planowania harmonogramów prac utrzymaniowych dla urządzeń operacyjnych. SAP przedstawia ten proces jako zbieranie danych z zasobów, przesyłanie ich w czasie rzeczywistym, wykorzystywanie sztucznej inteligencji lub uczenia maszynowego oraz podejmowanie działań na podstawie uzyskanych wniosków.
Predictive maintenance jest stosowane w produkcji, branży oil & gas, motoryzacji, kolejnictwie, energetyce, lotnictwie, górnictwie, utilities, logistyce oraz innych sektorach intensywnie wykorzystujących zasoby techniczne. Jego celem nie jest zastąpienie zespołów utrzymania ruchu, ale zapewnienie im lepszego wyczucia momentu działania, solidniejszych podstaw decyzyjnych oraz wyraźniejszego powiązania między kondycją zasobów a ryzykiem operacyjnym.
Czym jest predictive maintenance?
Predictive maintenance, często skracane do PdM, to proaktywna strategia utrzymania ruchu, która wykorzystuje dane do oceny stanu urządzeń i przewidywania, kiedy będzie potrzebna konserwacja lub naprawa. To podejście opiera się na aktualnym stanie technicznym maszyny i na danych. Decyzje o działaniach utrzymaniowych wynikają nie z samego harmonogramu, ale z informacji z czujników, historii awarii, warunków pracy oraz modeli analitycznych.
System predictive maintenance zwykle monitoruje takie sygnały jak:
- wibracje,
- temperatura,
- ciśnienie,
- prąd,
- stan oleju,
- emisja akustyczna,
- prędkość,
- obciążenie,
- godziny pracy,
- alarmy,
- historia utrzymania ruchu.
Te sygnały są analizowane po to, aby wykrywać oznaki pogarszającego się stanu maszyny, ocenić ryzyko awarii lub oszacować, jak długo urządzenie może jeszcze bezpiecznie pracować. Wynikiem nie powinien być jednak wyłącznie wykres albo alert. Dojrzały proces predykcyjnego utrzymania ruchu powinien prowadzić do konkretnej decyzji: przeprowadzić inspekcję, nasmarować elementy, wykonać regulację, zaplanować zlecenie serwisowe, zamówić części, zaplanować postój albo kontynuować monitoring.
To ważne rozróżnienie. Predictive maintenanc nie polega po prostu na zainstalowaniu czujników. Czujniki dostarczają dane, ale dopiero ich analiza pozwala zamienić te dane w decyzję podjętą zanim dojdzie do awarii.
Znaczenie predictive maintenance w produkcji
W produkcji predictive maintenance oznacza wykorzystanie danych maszynowych i procesowych do ograniczania nieplanowanych przestojów, poprawy dostępności zasobów i planowania utrzymania ruchu wokół potrzeb produkcyjnych. Największą wartość daje przy urządzeniach, których awaria jest kosztowna, krytyczna dla bezpieczeństwa, krytyczna dla jakości albo trudna do naprawy pod presją czasu.
Typowe zasoby produkcyjne obejmują:
- silniki,
- pompy,
- sprężarki,
- przekładnie,
- przenośniki,
- wentylatory,
- turbiny,
- wrzeciona,
- prasy,
- piece,
- maszyny pakujące,
- roboty spawalnicze,
- maszyny CNC,
- napędy przemysłowe.
Predictive maintenance w produkcji często bazuje na danych z PLC, systemów SCADA, MES, historianów, sensorów IoT, CMMS, EAM oraz systemów jakościowych. Dane o stanie maszyny pokazują, jak zachowuje się zasób. Kontekst produkcyjny pokazuje, jaki produkt, zlecenie, zmiana, obciążenie albo stan procesu były aktywne, gdy sygnał uległ zmianie.
Ten kontekst ma znaczenie. Wzrost temperatury silnika może być normalny przy wysokim obciążeniu, ale nienormalny przy stabilnych warunkach pracy. Wzrost wibracji może być spodziewany po zmianie procesu, ale istotny, jeśli pojawia się podczas normalnej pracy. Predictive maintenance staje się bardziej użyteczne, gdy łączy dane o stanie zasobu z kontekstem operacyjnym.
Dla szerszej widoczności fabryki PdM można powiązać z monitorowaniem produkcji production monitoring, ale jest to osobny temat. PdM może również wpływać na dostępność OEE poprzez ograniczanie nieplanowanych postojów, natomiast formuła OEE powinna być omówiona w dedykowanym przewodniku po OEE.
Porównanie czterech strategii utrzymania ruchu
Predictive maintenance jest jedną z kilku strategii utrzymania ruchu. Najłatwiej je zrozumieć w porównaniu z reactive maintenance, preventive maintenance i condition-based maintenance.
| Strategia | Podejście | Timing | Podstawa danych | Najlepsze zastosowanie |
| Reactive maintenance | Praca do momentu awarii | Po awarii | Brak albo minimalne dane | Zasoby niekrytyczne, tanie i łatwe do wymiany |
| Preventive maintenance | Serwis według kalendarza albo zużycia | Zaplanowane interwały | Rekomendacje producenta, doświadczenie, godziny pracy | Urządzenia bez sensorów albo z przewidywalnymi wzorcami zużycia |
| Condition-based maintenance | Interwencja na podstawie progów | Gdy limity stanu zostaną przekroczone | Dane z sensorów w czasie rzeczywistym i zdefiniowane progi | Monitorowane zasoby z jasnymi limitami stanu |
| Predictive maintenance | Prognozowanie awarii | Przed przewidywaną awarią | Dane z sensorów, awarie historyczne, modele ML, kontekst zasobu | Zasoby krytyczne, kosztowne, istotne dla bezpieczeństwa lub produkcji |
Reactive maintenance może być akceptowalne dla tanich zasobów, których awaria ma niewielki wpływ operacyjny. Preventive maintenance jest przydatne, gdy wzorce awarii zależą od czasu lub zużycia oraz gdy pokrycie sensorami jest ograniczone. Condition-based maintenance jest skuteczne, gdy istnieją jasne, mierzalne progi. Predykcyjne utrzymanie ruchu jest najbardziej użyteczne wtedy, gdy organizacja chce prognozować degradację zanim zasób przekroczy krytyczny limit.
Predictive maintenance często opisuje się jako zaawansowaną formę condition-based maintenance.
Predictive maintenance vs preventive maintenance
Główna różnica między predictive maintenance a preventive maintenance dotyczy logiki czasowej. Preventive maintenance jest sterowane harmonogramem. Predictive maintenance jest sterowane stanem i prognozą.
Preventive maintenance może zakładać wymianę łożyska co sześć miesięcy, ponieważ tak wynika z kalendarza. Predictive maintenance analizuje wibracje, temperaturę, obciążenie oraz historyczne wzorce awarii, aby określić, czy dane łożysko jest nadal w dobrym stanie, czy wchodzi już w okno ryzyka awarii.
Ta różnica ma znaczenie, ponieważ preventive maintenance może generować dwa rodzaje strat:
- zbyt wczesną wymianę części,
- przeoczenie awarii, które wystąpią przed zaplanowanym interwałem.
Predictive maintenance ma ograniczać oba ryzyka. Planuje prace wtedy, gdy dane wskazują, że są potrzebne, a nie tylko dlatego, że nadeszła stała data.
Nie oznacza to, że preventive maintenance jest przestarzałe. Wielu producentów wykorzystuje oba podejścia. Kontrole bezpieczeństwa, inspekcje wymagane przepisami, rutyny smarowania i zadania compliance mogą nadal odbywać się według zaplanowanych interwałów. Predictive maintenance zwykle wdraża się najpierw dla krytycznych zasobów, gdzie ryzyko awarii i koszt przestoju uzasadniają inwestycję w dane i system.
| Kryterium | Utrzymanie prewencyjne | Utrzymanie predykcyjne |
| Logika harmonogramu | Kalendarz / licznik godzin pracy | Stan techniczny + prognoza zużycia |
| Wymagania dot. danych | Minimalne (zalecenia producenta OEM) | Czujniki, historia awarii, modele ML |
| Koszt nadmiernej konserwacji | Wysoki (wymiana części „na zapas”) | Niski (wymiana na podstawie danych) |
| Koszt niedostatecznej konserwacji | Średni (awarie między przeglądami) | Niski (ciągły monitoring stanu) |
| Najlepsze zastosowanie | Zasoby o zużyciu zależnym od czasu | Krytyczne zasoby z wykrywalną degradacją |
| Główny driver ROI | Mniej napraw awaryjnych | Uniknięcie nieplanowanych przestojów |
| Złożoność wdrożenia | Niska | Średnio-wysoka |
Predictive maintenance vs reactive maintenance
Reactive maintenance oznacza naprawę urządzenia po awarii. Jest proste, ale może być kosztowne, gdy awarie przerywają produkcję, uszkadzają powiązane urządzenia, tworzą ryzyka bezpieczeństwa albo wymagają awaryjnego zakupu części zamiennych.
Predictive maintenance jest proaktywną alternatywą dla reactive maintenance. Próbuje zidentyfikować potencjalną awarię zanim zasób osiągnie awarię funkcjonalną. Celem nie jest wyeliminowanie każdej awarii. Celem jest sprawienie, aby więcej awarii było widocznych wystarczająco wcześnie, by można było zaplanować działanie.
Na przykład pompa może wykazywać rosnące wibracje na kilka tygodni przed awarią. Podejście reaktywne czeka, aż pompa się zatrzyma. Podejście predykcyjne oznacza wykrycie trendu, oszacowanie ryzyka i uruchomienie inspekcji albo planowania work order, gdy produkcja nadal może wybrać najmniej zakłócające okno utrzymaniowe.
W tym miejscu predictive maintenance wspiera strategię zarządzania zasobami. Daje zespołom utrzymania ruchu i operacji więcej czasu na planowanie, priorytetyzację i koordynację.
Jak działa predictive maintenance?
Predictive maintenance działa poprzez sekwencję zbierania danych, analizy, alertowania i działania. Typowy przepływ wygląda następująco:
sensor -> data stream -> model -> alert -> work order -> feedback
W praktyce proces wygląda tak:
- Sensory zbierają dane z urządzeń.
- Urządzenia edge albo gatewaye przesyłają dane do platformy.
- Dane są przechowywane, czyszczone i kontekstualizowane.
- Modele analityczne albo machine learning wykrywają wzorce degradacji.
- System przewiduje prawdopodobieństwo awarii albo Remaining Useful Life.
- Generowany jest alert predictive maintenance.
- CMMS albo EAM tworzy lub aktualizuje work order.
- Działanie utrzymaniowe zostaje wykonane.
- Wynik wraca do modelu i historii zasobu.
SAP opisuje czteroetapową architekturę predictive maintenance i industrial IoT: zbieranie danych z sensorów, przesyłanie ich w czasie rzeczywistym, zastosowanie AI i machine learning oraz podjęcie działania poprzez odpowiedź automatyczną albo ludzką.
System predictive maintenance powinien więc obejmować zarówno warstwę analityczną, jak i operacyjną. Model, który przewiduje problem, jest użyteczny tylko wtedy, gdy organizacja może zareagować na prognozę. Zwykle wymaga to integracji z planowaniem prac utrzymaniowych, magazynem części zamiennych, zleceniami serwisowymi oraz harmonogramowaniem produkcji.
Źródła danych wykorzystywane w predictive maintenance
Predictive maintenance zależy od danych z urządzeń, kontekstu operacyjnego i historycznych wyników. Najczęstsze źródła danych to:
| Źródło danych | Typowe sygnały | Zastosowanie w predictive maintenance |
| Sensory wibracji | przyspieszenie, prędkość, widmo częstotliwości | zużycie łożysk, niewyważenie, niewspółosiowość, luzy |
| Sensory temperatury | temperatura powierzchni, temperatura łożyska, temperatura silnika | przegrzewanie, problemy ze smarowaniem, problemy elektryczne |
| Sensory ciśnienia | zmiany ciśnienia, spadki ciśnienia, fluktuacje | nieszczelności, blokady, problemy z pompą lub sprężarką |
| Prąd i napięcie | sygnatura prądowa, obciążenie, jakość zasilania | usterki silników, problemy z napędami, degradacja izolacji |
| Dane olejowe i płynowe | lepkość, liczba cząstek, metale zużyciowe, zanieczyszczenie wodą | degradacja smarowania, zużycie wewnętrzne |
| Dane akustyczne i ultradźwiękowe | dźwięk wysokiej częstotliwości, emisja akustyczna | nieszczelności, wyładowania niezupełne, wczesne usterki łożysk |
| Dane SCADA i PLC | stany, alarmy, wartości procesowe, cykle | kontekst operacyjny i historia zdarzeń |
| Dane CMMS i EAM | work orders, kody awarii, naprawy, części | historyczne działania utrzymaniowe i wyniki awarii |
| Dane MES | zlecenia, produkty, operacje, partie | kontekst produkcyjny i wykorzystanie zasobu |
| Dane historian | trendy time-series | długoterminowe wzorce pracy |
Dane historyczne o awariach są szczególnie cenne w przypadku nadzorowanego uczenia maszynowego. Jeśli organizacja wie, kiedy dochodziło do awarii i jakie sygnały je poprzedzały, modele mogą uczyć się wzorców związanych z przyszłymi awariami. W wielu firmach historia awarii jest jednak niepełna, niespójna albo zapisywana wyłącznie w opisach tekstowych zleceń serwisowych. To jeden z powodów, dla których projekty predykcyjnego utrzymania ruchu często zaczynają się od przygotowania danych, zanim powstaną właściwe modele.
Techniki predictive maintenance
Predykcyjne utrzymanie ruchu wykorzystuje różne techniki monitorowania. Wybór właściwej metody zależy od rodzaju zasobu, typu awarii, warunków pracy oraz czasu, jaki zwykle upływa od pierwszych oznak pogorszenia stanu urządzenia do faktycznej awarii.
Analiza wibracji
Analiza wibracji jest jedną z najczęściej stosowanych technik predictive maintenance dla urządzeń wirujących. Wykorzystuje sensory akcelerometryczne do wykrywania wzorców związanych z niewyważeniem, niewspółosiowością, luzami mechanicznymi, zużyciem łożysk, defektami przekładni, rezonansem i innymi problemami mechanicznymi.
Sygnały wibracyjne są często analizowane w domenie częstotliwości przy użyciu FFT, czyli Fast Fourier Transform. FFT przekształca sygnał wibracji z domeny czasu na komponenty częstotliwościowe, co ułatwia identyfikację charakterystycznych częstotliwości uszkodzeń.
Analiza wibracji jest szczególnie istotna dla:
- silników,
- pomp,
- sprężarek,
- wentylatorów,
- przekładni,
- turbin,
- wrzecion,
- wałów wirujących.
ISO 20816 określa ogólne warunki i procedury pomiaru oraz oceny drgań maszyn, a ISO 10816 jest starszą, powiązaną serią wykorzystywaną do oceny drgań na nieruchomych częściach maszyn.
Analiza wibracji często wykrywa degradację wcześniej niż metody termiczne, ponieważ usterki mechaniczne mogą pojawiać się w sygnaturze wibracyjnej zanim wygenerują znaczące ciepło. Dlatego wibracje często umieszcza się wcześniej na krzywej P-F.
Analiza termiczna i termowizja
W tej metodzie wykorzystuje się kamery termowizyjne lub czujniki temperatury, aby wykrywać miejsca, w których pojawia się nietypowe nagrzewanie. W przypadku kamer termowizyjnych pomiar odbywa się bezkontaktowo. Dzięki temu technika ta jest często stosowana do kontroli instalacji elektrycznych, elementów mechanicznych, izolacji, zatorów, nadmiernego tarcia oraz problemów z chłodzeniem.
Typowe zastosowania obejmują:
- rozdzielnice i panele elektryczne,
- silniki,
- łożyska,
- systemy parowe,
- piece,
- wyłożenia ogniotrwałe,
- wymienniki ciepła,
- zablokowane rurociągi,
- przegrzewające się połączenia.
Analiza termiczna jest użyteczna, ponieważ ciepło jest widocznym symptomem naprężenia, oporu, tarcia, przeciążenia albo zablokowanego przepływu. Nie zawsze wykrywa najwcześniejszą oznakę awarii, ale jest praktyczna, szybka i przydatna dla wielu typów zasobów.
Analiza oleju i płynów
Analiza oleju monitoruje stan środków smarnych oraz urządzeń, które są przez nie chronione. Może mierzyć lepkość, liczbę cząstek, zanieczyszczenie wodą, utlenianie, wyczerpanie dodatków i metale zużyciowe przy użyciu metod takich jak spektroskopia.
Analiza oleju jest szczególnie istotna dla:
- przekładni,
- silników,
- układów hydraulicznych,
- turbin,
- sprężarek,
- łożysk smarowanych,
- ciężkiego sprzętu mobilnego.
Na przykład rosnąca liczba cząstek żelaza, miedzi albo chromu może wskazywać na zużycie komponentów wewnętrznych. Zanieczyszczenie wodą może wskazywać na problemy z uszczelnieniem. Zmiana lepkości może sugerować degradację lub zanieczyszczenie środka smarnego.
Analiza oleju jest wartościowa, ponieważ środek smarny często przenosi dowody wewnętrznego zużycia zanim zasób ulegnie awarii funkcjonalnej.
Analiza ultradźwiękowa i akustyczna
Analiza ultradźwiękowa i akustyczna wykrywa wzorce dźwiękowe, szczególnie sygnały wysokiej częstotliwości, które nie zawsze są słyszalne dla człowieka. Może być wykonywana w powietrzu albo przez strukturę urządzenia.
Typowe zastosowania obejmują:
- nieszczelności sprężonego powietrza,
- nieszczelności próżni,
- problemy z odwadniaczami parowymi,
- usterki łożysk,
- problemy ze smarowaniem,
- wyładowania niezupełne w systemach elektrycznych.
Inspekcja ultradźwiękowa jest przydatna w hałaśliwych środowiskach przemysłowych, ponieważ sygnały wysokiej częstotliwości można odseparować od tła o niższej częstotliwości. Często wykorzystuje się ją jako praktyczną technikę wykrywania nieszczelności i wczesnych usterek łożysk.
Monitoring elektryczny
Monitoring elektryczny analizuje napięcie, prąd, jakość zasilania, rezystancję izolacji i wzorce sygnatury prądowej silnika. Motor Current Signature Analysis, czyli MCSA, może pomagać w identyfikowaniu usterek silników i napędów przez wykrywanie nieprawidłowych wzorców w prądzie.
Typowe zastosowania obejmują:
- silniki,
- napędy,
- pompy,
- sprężarki,
- przenośniki,
- szafy elektryczne,
- systemy izolacji.
Monitoring elektryczny może identyfikować problemy takie jak defekty prętów wirnika, problemy stojana, niewyważenie, przeciążenie, problemy z jakością zasilania albo degradacja izolacji. Jest szczególnie wartościowy tam, gdzie dostęp mechaniczny jest trudny, ale dostępne są pomiary elektryczne.
Krzywa P-F
Krzywa P-F jest jednym z najważniejszych pojęć w predictive maintenance. Opisuje interwał między najwcześniejszą wykrywalną oznaką problemu a punktem, w którym zasób nie może już wykonywać wymaganej funkcji.
- P = potential failure: najwcześniejszy wykrywalny sygnał, że degradacja się rozpoczęła.
- F = functional failure: punkt, w którym zasób nie wykonuje już wymaganej funkcji.
- P-F interval: okno czasowe dostępne na wykrycie, zaplanowanie i działanie przed awarią.
Wartość predictive maintenance zależy od wykrywania problemów w ramach P-F interval na tyle wcześnie, aby podjąć działanie. Dłuższy P-F interval daje zespołom utrzymania ruchu więcej czasu na zaplanowanie prac, zamówienie części zamiennych, koordynację z produkcją i uniknięcie awaryjnej naprawy.
Różne techniki wykrywają awarie w różnych punktach krzywej P-F. Analiza wibracji może wcześnie wykryć degradację mechaniczną. Analiza oleju może ujawnić wewnętrzne zużycie zanim wibracje staną się poważne. Analiza termiczna może wykrywać późniejsze stadium tarcia lub nagrzewania elektrycznego. Analiza ultradźwiękowa może wcześnie wykrywać nieszczelności albo wyładowania niezupełne w konkretnych zastosowaniach.
Monitorowanie stanu technicznego pomaga określić punkty wykrywania na krzywej P-F, czyli między pierwszymi oznakami pogorszenia stanu urządzenia a jego faktyczną awarią. Pełną metodykę monitorowania stanu warto jednak omówić w osobnym przewodniku poświęconym temu tematowi.
Remaining Useful Life (RUL)
Remaining Useful Life, czyli RUL, to przewidywany czas do momentu, w którym zasób osiągnie awarię funkcjonalną. Jest jednym z kluczowych wyników modeli predictive maintenance.
RUL można wyrazić w:
- godzinach,
- cyklach,
- dniach,
- partiach produkcyjnych,
- dystansie,
- zdarzeniach operacyjnych,
- przedziałach prawdopodobieństwa.
Na przykład model może przewidzieć, że łożysko ma 120 godzin pracy zanim ryzyko awarii stanie się nieakceptowalne. Inny model może przypisać zasób do przedziału time-to-failure, takiego jak „0-7 dni”, „8-30 dni” albo „więcej niż 30 dni”.
Modele RUL mogą być:
- oparte na regresji, przewidują konkretną wartość czasu,
- oparte na klasyfikacji, przewidują kategorię ryzyka lub przedział czasowy,
- oparte na wiedzyfizycznej,wykorzystują równania degradacji i wiedzę inżynierską,
- oparte na danych, korzystają z historycznych danych z czujników i danych o awariach,
- hybrydowe, łączą wiedzę o fizyce procesu z uczeniem maszynowym.
RUL nie powinien być traktowany jako precyzyjna gwarancja. To sygnał planistyczny. Jego użyteczność zależy od jakości danych, spójności failure modes, warunków pracy, walidacji modelu i informacji zwrotnych z utrzymania ruchu.
Po integracji z CMMS albo EAM, RUL może uruchamiać planowanie work orders, planowanie części zamiennych i koordynację z produkcją.
Uczenie maszynowe w predykcyjnym utrzymaniu ruchu
Uczenie maszynowe jest silnikiem analitycznym wielu systemów predykcyjnego utrzymania ruchu. Analizuje strumienie danych z czujników, historię awarii, kontekst pracy urządzeń oraz efekty działań utrzymaniowych, aby wykrywać wzorce, które trudno uchwycić za pomocą sztywnych reguł.
Najczęściej stosowane podejścia oparte na uczeniu maszynowym obejmują:
| Typ modelu | Typowy wynik | Zastosowanie w PdM |
| Klasyfikacja | awaria / brak awarii, typ awarii, kategoria ryzyka | identyfikacja, czy zasób prawdopodobnie ulegnie awarii |
| Regresja | wartość ciągła | szacowanie Remaining Useful Life |
| Wykrywanie anomalii | odchylenie od normalnego zachowania | oznaczanie nietypowego zachowania urządzeń |
| Klasteryzacja / grupowanie | grupy podobnych zachowań | identyfikacja trybów pracy albo ukrytych wzorców |
| Prognozowanie szeregów czasowych | przewidywane przyszłe wartości | prognozowanie trendów degradacji |
| Uczenie głębokie | cechy wyuczone z danych surowych | analiza złożonych sygnałów, wibracji, dźwięku i obrazów |
Uczenie nadzorowane wykorzystuje oznaczone przykłady historyczne, takie jak wcześniejsze awarie i poprzedzające je dane z czujników. Uczenie nienadzorowane może być stosowane, gdy liczba etykietowanych przypadków awarii jest ograniczona, na przykład do wykrywania anomalii lub grupowania podobnych wzorców pracy. Metody deep learning, takie jak modele LSTM, mogą być wykorzystywane dla sekwencyjnych danych time-series, natomiast CNN mogą być stosowane do reprezentacji sygnałów lub obrazów.
Inżynieria cech jest często równie ważna jak wybór samego modelu. Przydatne cechy mogą obejmować m.in. wartość skuteczną drgań (RMS), kurtozę, wartości szczytowe, pasma częstotliwości, gradienty temperatury, wahania ciśnienia, prąd odniesiony do obciążenia czy tempo zmian w czasie.
Wykrywanie anomalii i analiza szeregów czasowych są ważnymi elementami predykcyjnego utrzymania ruchu, ale warto omówić je szerzej w osobnych artykułach poświęconych tym zagadnieniom.
Sensory IoT i przetwarzanie brzegowe w predictive maintenance
IoT w predykcyjnym utrzymaniu ruchu oznacza wykorzystanie połączonych czujników przemysłowych, urządzeń brzegowych oraz platform danych do ciągłego lub niemal bieżącego monitorowania stanu technicznego zasobów.
Typowe rodzaje sensorów IoT obejmują:
- bezprzewodowe sensory wibracji,
- sensory temperatury,
- sensory ciśnienia,
- sensory akustyczne,
- sensory prądu,
- sensory stanu oleju,
- sensory wilgotności,
- sensory prędkości.
Częstotliwość próbkowania zależy od rodzaju sygnału. Niektóre wartości można zbierać co kilka sekund lub minut. Dane wibracyjne i akustyczne mogą jednak wymagać próbkowania na poziomie milisekund albo akwizycji z wysoką częstotliwością, zwłaszcza gdy potrzebna jest analiza częstotliwościowa.
Przetwarzanie brzegowe stosuje się wtedy, gdy dane trzeba analizować blisko maszyny. Bramka brzegowa może filtrować sygnały, obliczać cechy, kompresować dane, wykrywać lokalne anomalie, buforować dane podczas przerw w łączności oraz przesyłać wybrane strumienie danych do platform chmurowych lub lokalnych.
Typowe wzorce komunikacji przemysłowej obejmują MQTT, OPC UA, interfejsy REST API, konektory do systemów historian oraz potoki strumieniowania danych. AWS opisuje urządzenia IoT i inteligentne czujniki jako element strategii predykcyjnego utrzymania ruchu, wykorzystywany do monitorowania pracy maszyn.
IoT jest warstwą zbierania danych dla predykcyjnego utrzymania ruchu. Nie zastępuje inżynierii niezawodności, analizy trybów awarii ani planowania prac utrzymaniowych. Zapewnia dostęp do danych, dzięki którym decyzje mogą być podejmowane we właściwszym momencie.
Integracja CMMS i EAM
Predictive maintenance musi łączyć się z realizacją prac utrzymaniowych. Zwykle oznacza to integrację z systemem CMMS albo EAM.
CMMS, czyli Computerized Maintenance Management System, zarządza work orders, zadaniami, harmonogramami, częściami zamiennymi i historią utrzymania ruchu. EAM, czyli zarządzanie zasobami technicznymi przedsiębiorstwa, zwykle obejmuje szerszy cykl życia zasobów: ich strukturę i hierarchię, koszty, zgodność z wymaganiami, ryzyko oraz długoterminową efektywność.
W predictive maintenance integracja CMMS/EAM umożliwia:
- automatyczne generowanie work orders z alertów PdM,
- mapowanie hierarchii zasobów,
- analizę historii utrzymania ruchu,
- planowanie części zamiennych,
- przypisanie technika,
- informację zwrotną po wykonanych pracach,
- śledzenie false positives i missed failures.
Bez integracji z CMMS albo EAM alerty predictive maintenance mogą pozostać odizolowane od codziennego wykonywania prac utrzymaniowych. System może zidentyfikować problem, ale organizacja może nie przekształcić alertu w zaplanowaną pracę.
IBM Maximo to przykład platformy EAM do zarządzania zasobami technicznymi przedsiębiorstwa. Rozwiązanie koncentruje się na zarządzaniu zasobami, optymalizacji utrzymania ruchu, analizach wspieranych przez AI oraz procesach związanych z niezawodnością. Może być wdrażane zarówno jako oprogramowanie zarządzane przez klienta, jak i w modelu SaaS.
Predykcyjne utrzymanie ruchu w produkcji: MES, SCADA i kontekst zasobów
Predictive maintenance w produkcji działa najlepiej, gdy dane o stanie zasobu są połączone z kontekstem produkcyjnym. Sam sygnał wibracyjny może pokazywać, że łożysko się degraduje, ale dane produkcyjne mogą wyjaśnić, czy zasób był pod nietypowym obciążeniem, produkował określony produkt, pracował po przezbrojeniu albo działał podczas nienormalnego stanu procesu.
Przydatny kontekst produkcyjny obejmuje:
- hierarchię zasobów,
- linię i maszynę,
- zlecenie produkcyjne,
- produkt,
- partię,
- recepturę,
- prędkość,
- obciążenie,
- zmianę operatora,
- historię utrzymania ruchu,
- wyniki jakościowe,
- alarmy,
- zdarzenia OEE Availability.
MES dostarcza kontekst produkcyjny. SCADA dostarcza stany urządzeń i procesu. Historiany dostarczają historię time-series. CMMS dostarcza historię prac. Platforma predictive maintenance łączy te źródła danych, aby model mógł rozumieć nie tylko sygnał, ale także sytuację operacyjną.
W tym miejscu platforma danych przemysłowych może wspierać PdM: może łączyć dane OT i IT, mapować sygnały do zasobów, zapewniać kontekst zdarzeń i przekazywać wyniki do workflow utrzymania ruchu. Smart RDM, na przykład, jest pozycjonowany jako Industrial Data & AI Platform, która może łączyć dane przemysłowe, analitykę, raportowanie, knowledge management i operacyjne wsparcie decyzji w jednym środowisku.
Digital twins również mogą być używane w PdM do reprezentowania zasobów, symulowania zachowania albo kontekstualizowania wzorców degradacji, ale architektura digital twin jest osobnym tematem omawianym w dedykowanym przewodniku.
Korzyści i ROI z predictive maintenance
Korzyści z predictive maintenance należy oceniać w wymiarze operacyjnym i finansowym. Najczęściej wskazywane korzyści obejmują ograniczenie nieplanowanych przestojów, lepszą dostępność zasobów, usprawnione planowanie utrzymania ruchu, niższe koszty napraw awaryjnych, dłuższy cykl życia urządzeń oraz lepsze zarządzanie częściami zamiennymi.
Przegląd SAP wskazuje raportowane korzyści z programów predictive maintenance, w tym nawet do 15% redukcji przestojów, do 20% wzrostu produktywności pracy oraz do 30% redukcji zapasów.
To samo źródło SAP wymienia przykłady branżowe, w tym redukcję kosztów utrzymania ruchu w oil and gas nawet do 38%, roboty spawalnicze w automotive generujące miliony punktów danych dla dokładności predykcyjnej, wykrywanie pustek w kolejnictwie w celu poprawy bezpieczeństwa oraz przykład z branży stalowej raportujący 60% poprawę żywotności urządzeń.
Typowe obszary korzyści obejmują:
| Obszar korzyści | Jak PdM wnosi wartość |
| Przestoje | wykrywa degradację przed awarią |
| Praca utrzymania ruchu | przesuwa działania z napraw awaryjnych do prac planowanych |
| Części zamienne | poprawia planowanie zapasów i ogranicza zakupy awaryjne |
| Żywotność zasobów | zapobiega pracy urządzeń do stanu poważnej awarii |
| Bezpieczeństwo | ogranicza ryzyko awarii zasobów krytycznych |
| Planowanie produkcji | koordynuje utrzymanie ruchu z oknami produkcyjnymi |
| Jakość | wykrywa degradację urządzeń, która może wpływać na jakość produktu |
| Energia | identyfikuje nieefektywną pracę powiązaną z degradacją zasobu |
Energia może być zależna od stanu zasobu, ale energy optimization powinna być omawiana jako dedykowany temat.
ROI należy liczyć osobno dla każdego zasobu lub dla każdej klasy zasobów. Uzasadnienie biznesowe jest najsilniejsze wtedy, gdy koszt awarii jest wysoki, tryby awarii można wykryć odpowiednio wcześnie, a organizacja jest w stanie zareagować w czasie między pierwszymi oznakami pogorszenia stanu urządzenia a jego faktyczną awarią.
Wyzwania predictive maintenance
Predictive maintenance to nie tylko zakup oprogramowania. To zmiana operacyjna, która wymaga danych, wiedzy reliability, sensorów, workflow i adopcji przez zespoły utrzymania ruchu.
Najczęstsze wyzwania obejmują:
Wysoki koszt początkowy
Czujniki, bramki komunikacyjne, oprogramowanie, integracje oraz prace inżynierskie mogą być kosztowne. Dlatego predykcyjne utrzymanie ruchu warto zaczynać od zasobów krytycznych, w przypadku których koszt awarii uzasadnia taką inwestycję.
Jakość danych
Niska jakość danych może prowadzić do niewiarygodnych predykcji. Brakujące dane z sensorów, niespójne kody awarii, błędne znaczniki czasu i niepełna historia utrzymania ruchu obniżają jakość modelu.
Kalibracja i rozmieszczenie sensorów
Rozmieszczenie sensorów wpływa na jakość sygnału. Źle zamontowany akcelerometr może generować mylące odczyty wibracji. Sensory temperatury, prądu i akustyczne również wymagają właściwego rozmieszczenia oraz kalibracji.
Zależność od danych historycznych
Modele uczenia nadzorowanego wymagają przykładów awarii. W wielu zakładach nie ma jednak wystarczającej liczby oznaczonych danych o awariach, a informacje o nich są często zapisane jedynie w nieustrukturyzowanych notatkach w zleceniach serwisowych.
Szkolenie zespołu
Zespoły utrzymania ruchu muszą rozumieć, co oznaczają alerty predykcyjne, jak je walidować i jak na nie reagować. Bez szkolenia alerty mogą być ignorowane albo bezkrytycznie przeceniane.
Wyniki fałszywe dodatnie i ujemne
Wynik fałszywie dodatni prowadzi do niepotrzebnej inspekcji lub niepotrzebnych działań utrzymaniowych. Wynik fałszywie ujemny oznacza, że rzeczywiste ryzyko awarii nie zostaje wykryte. Oba przypadki powinny być monitorowane i wykorzystywane do poprawy skuteczności modelu.
Luki integracyjne
Jeśli alerty nie są połączone z CMMS, EAM, częściami zamiennymi i harmonogramem produkcji, predykcje mogą nie przełożyć się na działanie.
Zarządzanie zmianą
Predictive maintenance zmienia sposób planowania utrzymania ruchu. Zespoły przyzwyczajone do stałych harmonogramów albo reakcji awaryjnej mogą potrzebować czasu, aby zaufać planowaniu opartemu na danych.
Jak wdrożyć predictive maintenance?
Praktyczne wdrożenie predictive maintenance powinno być etapowe. Zbyt szeroki start może prowadzić do nadmiaru sensorów, słabej adopcji i niejasnego ROI.
Krok 1: Zidentyfikuj zasoby krytyczne
Zacznij od zasobów, których awaria ma mierzalny wpływ na produkcję, bezpieczeństwo, jakość, koszt albo dostawy. Do priorytetyzacji wykorzystaj krytyczność zasobów, historię utrzymania ruchu, koszt przestojów i ryzyko niezawodności.
FMEA, czyli analiza rodzajów i skutków awarii, może pomóc określić, które tryby awarii są istotne oraz czy można je wykryć odpowiednio wcześnie, aby zastosować predictive maintenance.
Krok 2: Zdefiniuj tryby awarii i techniki monitorowania
Predykcyjne utrzymanie ruchu powinno opierać się na analizie konkretnych trybów awarii. Dla silnika wirującego odpowiednie mogą być monitoring wibracji i prądu. Dla układu hydraulicznego większe znaczenie może mieć analiza oleju i monitoring ciśnienia. Dla panelu elektrycznego bardziej adekwatne mogą być termografia i monitoring elektryczny.
Krok 3: Zainstaluj sensory i zbierz dane bazowe
Zainstaluj wymagane sensory i zbierz dane bazowe w normalnych warunkach pracy. Dane bazowe pomagają zdefiniować, jak wygląda „normalność” dla każdego zasobu, produktu, obciążenia i stanu operacyjnego.
Krok 4: Połącz dane za pomocą infrastruktury brzegowej lub platformowej
Do zbierania i zarządzania danymi wykorzystuje się bramki brzegowe, systemy historian, platformy chmurowe lub platformy lokalne. W środowiskach przemysłowych często stosuje się protokoły takie jak MQTT i OPC UA.
Krok 5: Zbuduj reguły albo modele
Zacznij od prostych progów lub reguł eksperckich, jeśli dane historyczne o awariach są ograniczone. Modele uczenia maszynowego warto dodać wtedy, gdy dostępnych jest już wystarczająco dużo danych, aby wspierać klasyfikację, regresję, wykrywanie anomalii lub przewidywanie pozostałego czasu użytecznej pracy urządzenia.
Krok 6: Zintegruj z CMMS albo EAM
Alert predykcyjny powinien uruchamiać proces utrzymaniowy. Integracja z CMMS lub EAM pozwala generować zlecenia serwisowe, planować zadania, rezerwować części zamienne i przypisywać techników do konkretnych działań.
Krok 7: Monitoruj, waliduj i ulepszaj
Śledź trafność predykcji, wyniki fałszywie dodatnie, niewykryte awarie, efekty działań utrzymaniowych oraz wpływ biznesowy. Wnioski z tych działań powinny trafiać z powrotem do modelu oraz historii danego zasobu.
Warto zacząć od wąskiej grupy zasobów, potwierdzić wartość rozwiązania w praktyce, a dopiero potem rozszerzać je na kolejne obszary. Predictive maintenance przynosi najlepsze efekty wtedy, gdy organizacja potrafi przejść całą drogę: od wykrycia sygnału, przez ocenę ryzyka, aż po konkretne działanie utrzymaniowe.
Przykłady branżowe i use cases
Produkcja
W produkcji predictive maintenance służy do ograniczania nieplanowanych przestojów na urządzeniach krytycznych dla produkcji. Przykłady obejmują monitoring silników, przekładni, przenośników, sprężarek, maszyn pakujących, pras, wrzecion i robotów. Predykcyjne utrzymanie ruchu wspiera dostępność urządzeń i może poprawiać wskaźnik dostępności w OEE, nawet bez szczegółowego omawiania pełnej kalkulacji OEE.
Oil and gas
Zasoby oil and gas pracują w trudnych środowiskach, w których awaria może być kosztowna i krytyczna dla bezpieczeństwa. Przegląd SAP wskazuje przykład oil and gas, w którym monitoring temperatury oleju i prędkości przekładni w urządzeniach wiertniczych ograniczył koszty utrzymania ruchu nawet o 38%.
Motoryzacja
W branży motoryzacyjnej predictive maintenance wykorzystuje się m.in. w przypadku robotów spawalniczych, systemów montażowych, przenośników, lakierni, centrów obróbczych oraz pras. SAP opisuje przykład z sektora automotive, w którym połączone z systemem pistolety do zgrzewania punktowego generują miliony punktów danych wykorzystywanych do zwiększania trafności predykcji.
Kolej
Zastosowania kolejowe obejmują monitoring torów i taboru. Predictive maintenance może wspierać wykrywanie pustek, monitoring kół i łożysk, systemy hamulcowe oraz bezpieczeństwo infrastruktury. SAP opisuje wykrywanie pustek w kolejnictwie jako przykład predictive maintenance wspierającego bezpieczeństwo operacyjne.
Stal
Produkcja stali wykorzystuje dane o wibracjach, prędkości obrotowej i prądzie elektrycznym dla zasobów takich jak urządzenia walcowania na zimno. SAP przytacza przykład z branży stalowej, w którym anomaly detection przyczyniło się do 60% poprawy żywotności urządzeń.
Energetyka i utilities
W energetyce i sektorze utilities predictive maintenance stosuje się m.in. do monitorowania turbin, generatorów, transformatorów, analizy drgań turbin wiatrowych oraz oceny niezawodności zasobów sieciowych. W tym sektorze PdM często pomaga zarządzać zasobami o wysokiej wartości, które mają kluczowe znaczenie dla bezpieczeństwa i ciągłości działania.
Branża lotniczo-kosmiczna
W branży lotniczo-kosmicznej predictive maintenance wykorzystuje się do monitorowania stanu silników, oceny niezawodności komponentów oraz planowania obsługi technicznej samolotów. Główny nacisk kładzie się tu często na bezpieczeństwo, niezawodność i koszt całego cyklu życia, a nie wyłącznie na ograniczanie przestojów.
Górnictwo
Urządzenia górnicze pracują pod dużym obciążeniem, w pyle, wibracjach i trudnych warunkach środowiskowych. Predictive maintenance może wspierać haul trucks, przenośniki, kruszarki, młyny, pompy i zasoby mobilne.
Oprogramowanie predictive maintenance i przegląd dostawców 2026
Oprogramowanie do predykcyjnego utrzymania ruchu obejmuje szerokie spektrum rozwiązań: od platform do zarządzania zasobami przedsiębiorstwa i chmurowych usług AI, przez przemysłowe platformy IoT i systemy flotowe, po aplikacje zintegrowane z MES oraz specjalistyczne narzędzia do monitorowania konkretnych typów urządzeń.
Poniższy przegląd jest neutralny i informacyjny. Nie jest rankingiem.
| Vendor / source | Pozycjonowanie | Typowa rola |
| IBM | Predykcyjne utrzymanie ruchu i zarządzanie zasobami w skali przedsiębiorstwa, w tym Maximo | EAM, analizy wspierane przez AI, niezawodność zasobów, procesy utrzymania ruchu |
| SAP | Zarządzanie efektywnością zasobów i przegląd predykcyjnego utrzymania ruchu | Strategia zarządzania zasobami, APM, integracja z procesami biznesowymi |
| Wikipedia | Definicja encyklopedyczna | Ogólne źródło referencyjne |
| Splunk | Obserwowalność IT/OT i analiza danych | Obserwowalność oraz analityka danych operacyjnych |
| QAD | Kontekst operacji produkcyjnych powiązany z ERP/MES | Systemy produkcyjne i operacje przedsiębiorstwa |
| AWS | Chmurowe predykcyjne utrzymanie ruchu z wykorzystaniem IoT i uczenia maszynowego | Chmura, IoT, dane z czujników, rozwój modeli |
| Geotab | Predictive maintenance dla pojazdów i flot | Monitoring flot i zasobów transportowych |
| Brewer Science | Treści o predykcyjnym utrzymaniu ruchu z perspektywy produkcji | Edukacja na przykładach przemysłowych |
| PTC | ThingWorx i predykcyjne utrzymanie ruchu oparte na IIoT | Przemysłowy IoT i połączone zasoby |
| Smart RDM | Przemysłowa platforma danych i AI | Integracja danych przemysłowych, analityka, AI i wspieranie decyzji operacyjnych |
PTC przedstawia ThingWorx jako przemysłową platformę IoT, która wykorzystuje analitykę predykcyjną, aby pomagać producentom przechodzić od reaktywnego do proaktywnego utrzymania ruchu. AWS z kolei opisuje predykcyjne utrzymanie ruchu w kontekście urządzeń IoT, inteligentnych czujników i uczenia maszynowego wykorzystywanych do monitorowania pracy urządzeń.
Przy wyborze oprogramowania predictive maintenance producenci powinni ocenić:
- pokrycie zasobów,
- obsługę sensorów,
- opcje wdrożenia edge i cloud,
- integrację CMMS/EAM,
- wsparcie dla OPC UA i MQTT,
- transparentność modelu,
- zarządzanie alertami,
- predykcję RUL,
- data governance,
- cybersecurity,
- skalowalność multi-site,
- połączenie z kontekstem produkcyjnym.
Najlepsze rozwiązanie zależy od tego, czego potrzebuje organizacja: wąskiego narzędzia do monitorowania, procesu zintegrowanego z CMMS, platformy do zarządzania zasobami przedsiębiorstwa czy szerszej platformy danych przemysłowych.
Narzędzia predictive maintenance: co powinno się w nich znaleźć?
System predictive maintenance zwykle składa się z kilku warstw, a nie z jednego samodzielnego narzędzia.
| Warstwa | Przykłady |
| Akwizycja danych | czujniki, sterowniki PLC, bramki komunikacyjne, systemy historian |
| Łączność | OPC UA, MQTT, interfejsy API, strumieniowanie danych |
| Przechowywanie danych | baza danych szeregów czasowych, system historian, data lakehouse |
| Analityka | reguły, modele ML, wykrywanie anomalii, modele RUL |
| Wizualizacja | dashboardy, alerty, widoki trendów |
| Realizacja działań | CMMS, EAM, zlecenia serwisowe, części zamienne |
| Informacja zwrotna | potwierdzenie naprawy, etykiety awarii, ponowne trenowanie modelu |
Dobre narzędzie do predykcyjnego utrzymania ruchu nie powinno jedynie wykrywać nieprawidłowych danych. Powinno pomagać zespołom utrzymania ruchu zrozumieć, którego zasobu dotyczy problem, jaki tryb awarii może wystąpić, jakie jest ryzyko, jakie działanie należy podjąć i jaki proces pracy jest potrzebny, aby rozwiązać problem.
Predictive maintenance i generatywna AI
Generatywna AI może wspierać predictive maintenance, pomagając użytkownikom interpretować historię serwisową, dokumentację urządzeń, logi alarmów, zlecenia prac utrzymaniowych oraz rekomendacje diagnostyczne. Może też ułatwiać dostęp do wiedzy technicznej za pomocą pytań zadawanych językiem naturalnym.
Przykładowo technik może zapytać:
„Dlaczego ta sprężarka wygenerowała alert dotyczący łożyska?”
Przydatna odpowiedź powinna łączyć trendy z czujników, historię awarii, kontekst pracy urządzenia oraz odpowiednie fragmenty dokumentacji utrzymaniowej. Generatywna AI nie powinna jednak zastępować walidacji inżynierskiej. Jej rolą jest wspieranie decyzji człowieka, szczególnie w środowiskach, w których bezpieczeństwo lub ciągłość produkcji mają krytyczne znaczenie.
Właśnie tutaj przydatne mogą być generowanie wspierane wyszukiwaniem, wyszukiwanie semantyczne oraz kontrolowane źródła wiedzy. Pełne omówienie tego tematu lepiej umieścić w szerszym artykule o AI w produkcji lub zarządzaniu wiedzą przemysłową.
Źródła i dalsza lektura
Definicje predictive maintenance i koncepcje wdrożeniowe są omawiane przez IBM, AWS i SAP. IBM opisuje PdM jako ocenę stanu urządzeń w czasie rzeczywistym; AWS przedstawia je jako szacowanie i planowanie utrzymania ruchu urządzeń operacyjnych; SAP wyjaśnia workflow IoT i AI od sensorów do działania.
W przypadku monitorowania drgań norma ISO 20816 określa ogólne warunki i procedury pomiaru oraz oceny drgań maszyn. ISO 10816 to starsza, powiązana seria norm dotyczących oceny drgań.
W obszarze oprogramowania do monitorowania stanu maszyn oraz obsługi informacji norma ISO 13374 zawiera wytyczne dotyczące przetwarzania danych, komunikacji i prezentacji informacji związanych z monitorowaniem stanu technicznego oraz diagnostyką maszyn.
W branży półprzewodników i high-tech standard SEMI E10 określa podstawowe stany pracy urządzeń oraz zasady pomiaru ich niezawodności, dostępności, łatwości utrzymania i stopnia wykorzystania.
FAQ
Czym jest predictive maintenance?
Predictive maintenance to strategia utrzymania ruchu oparta na danych, która wykorzystuje dane z sensorów, stan urządzeń, historyczne awarie i modele analityczne do przewidywania, kiedy należy wykonać utrzymanie ruchu zanim dojdzie do awarii funkcjonalnej.
Jaka jest definicja predictive maintenance?
Predictive maintenance t o proaktywna strategia oparta na stanie technicznym urządzeń. Pozwala prognozować ryzyko awarii lub przewidywać pozostały czas użytecznej pracy maszyny na podstawie bieżących danych z urządzeń oraz historycznych informacji utrzymaniowych.
Co oznacza predictive maintenance w produkcji?
W produkcji predictive maintenance oznacza wykorzystanie danych maszynowych, kontekstu produkcyjnego i historii utrzymania ruchu do ograniczania nieplanowanych przestojów i planowania utrzymania zanim krytyczne urządzenie ulegnie awarii.
Jakie są cztery typy utrzymania ruchu?
Cztery najczęściej porównywane strategie utrzymania ruchu to reactive maintenance, preventive maintenance, condition-based maintenance i predictive maintenance.
Jakie są trzy typy predictive maintenance?
To sformułowanie bywa różnie rozumiane, ale najczęściej do technik predictive maintenance zalicza się analizę drgań, analizę termiczną, termowizję oraz analizę oleju lub innych płynów eksploatacyjnych. Szeroko stosuje się także diagnostykę ultradźwiękową i monitoring parametrów elektrycznych.
Jaka jest różnica między predictive maintenance a preventive maintenance?
Preventive maintenance jest oparte na kalendarzu albo zużyciu. Predictive maintenance jest oparte na stanie i prognozie. Preventive maintenance działa według harmonogramu, a predictive maintenance działa wtedy, gdy dane wskazują przyszłe ryzyko awarii.
Czym jest condition-based maintenance?
Condition-based maintenance uruchamia działania utrzymania ruchu, gdy mierzone warunki urządzeń przekraczają progi. Predictive maintenance rozwija to podejście, pozwalając prognozować przyszłe prawdopodobieństwo awarii lub pozostały czas użytecznej pracy urządzenia.
Jak działa predictive maintenance?
Predictive maintenance działa przez zbieranie danych z czujników, przesyłanie ich przez infrastrukturę brzegową lub platformę danych, a następnie analizowanie z wykorzystaniem reguł albo modeli uczenia maszynowego. Wynikiem tej analizy są alerty, które mogą uruchamiać konkretne działania utrzymaniowe w ramach procesów CMMS lub EAM.
Czym jest krzywa P-F?
Krzywa P-F opisuje przedział między pierwszymi oznakami potencjalnej awarii a awarią funkcjonalną. Predictive maintenance pomaga wykrywać problemy na wczesnym etapie tego przedziału, aby zespoły utrzymania ruchu miały czas na zaplanowanie działań korygujących.
Czym jest RUL?
RUL oznacza Remaining Useful Life. To przewidywany czas, liczba cykli albo okres pracy do momentu, w którym zasób powinien osiągnąć awarię funkcjonalną.
Czym jest analiza wibracji w predictive maintenance?
Analiza wibracji wykorzystuje akcelerometry i przetwarzanie sygnałów, często z FFT, do wykrywania problemów mechanicznych takich jak niewyważenie, niewspółosiowość, luzy, zużycie łożysk i usterki przekładni.
Czym jest analiza termiczna w predictive maintenance?
Analiza termiczna wykorzystuje termografię w podczerwieni albo sensory temperatury do wykrywania wzorców cieplnych, hotspots, usterek elektrycznych, blokad, tarcia albo problemów z chłodzeniem.
Czym jest analiza oleju w predictive maintenance?
Analiza oleju ocenia stan środka smarnego i zużycie urządzenia na podstawie wskaźników takich jak lepkość, liczba cząstek, zanieczyszczenie wodą, spektroskopia i metale zużyciowe.
Czym jest analiza ultradźwiękowa w predictive maintenance?
Analiza ultradźwiękowa wykrywa wzorce dźwięków wysokiej częstotliwości i jest stosowana do wykrywania nieszczelności, usterek łożysk, problemów ze smarowaniem i wyładowań niezupełnych w systemach elektrycznych.
Czym jest monitoring elektryczny w predictive maintenance?
Monitoring elektryczny analizuje napięcie, prąd, jakość zasilania, rezystancję izolacji i wzorce sygnatury prądowej silnika w celu wykrywania problemów z silnikami, napędami i systemami elektrycznymi.
Czym jest predictive maintenance IoT?
Predictive maintenance IoT wykorzystuje połączone czujniki, bramki brzegowe i platformy danych do zbierania informacji o stanie urządzeń, a następnie przekazywania ich do analizy, alertowania i planowania działań utrzymaniowych.
Jak machine learning jest wykorzystywany w predictive maintenance?
Machine learning jest wykorzystywane do klasyfikacji usterek, predykcji Remaining Useful Life, wykrywania anomalii, grupowania podobnych przypadków oraz prognozowania szeregów czasowych na podstawie danych z czujników i historycznych danych o awariach.
Czym jest CMMS w predictive maintenance?
CMMS zarządza zleceniami serwisowymi, harmonogramami utrzymania ruchu, częściami zamiennymi oraz historią zasobów. W predictive maintenance integracja z CMMS pozwala zamieniać alerty predykcyjne w konkretne działania utrzymaniowe.
Jakie są korzyści predictive maintenance?
Predictive maintenance może ograniczać przestoje, poprawiać produktywność pracy, optymalizować zapasy części zamiennych, wydłużać żywotność zasobów, poprawiać bezpieczeństwo i wspierać planowanie utrzymania ruchu. SAP wskazuje raportowane korzyści, w tym do 15% redukcji przestojów, do 20% wzrostu produktywności pracy i do 30% redukcji zapasów.
Jakie są wyzwania predictive maintenance?
Typowe wyzwania obejmują wysokie koszty początkowe, niską jakość danych, ograniczoną historię awarii, konieczność kalibracji czujników, luki integracyjne, fałszywe alerty, szkolenie zespołów oraz trudność w przekładaniu predykcji na konkretne zlecenia serwisowe.
Jak wdrożyć predictive maintenance?
Wdrożenie zwykle obejmuje kilka kroków: identyfikację zasobów krytycznych, określenie trybów awarii, wybór technik monitorowania, instalację czujników, zebranie danych bazowych, budowę modeli, integrację z CMMS lub EAM, monitorowanie wyników oraz ciągłe doskonalenie.
Czym jest predictive maintenance w AI?
AI w predictive maintenance wykorzystuje uczenie maszynowe, modele statystyczne, a czasem także generatywną AI do analizy danych z urządzeń, wykrywania oznak degradacji, szacowania pozostałego czasu użytecznej pracy oraz wspierania decyzji utrzymaniowych.
Czym są TPM i PPM?
TPM oznacza Total Productive Maintenance, czyli podejście utrzymaniowo-produkcyjne skoncentrowane na efektywności urządzeń. PPM często oznacza Planned Preventive Maintenance, ale terminologia różni się w zależności od organizacji.
Podsumowanie
Predictive maintenance pomaga zespołom odejść od sztywnych harmonogramów i napraw awaryjnych na rzecz planowania opartego na danych. Wykorzystuje dane z czujników, kontekst pracy urządzeń, uczenie maszynowe oraz historię działań utrzymaniowych, aby wykrywać pogarszający się stan maszyny, zanim dojdzie do awarii funkcjonalnej.
Jego wartość zależy jednak nie tylko od samych modeli. Skuteczny system predykcyjnego utrzymania ruchu wymaga niezawodnych czujników, uporządkowanych danych, dobrze określonych trybów awarii, użytecznego przedziału P-F, integracji z CMMS lub EAM, przeszkolonych użytkowników oraz informacji zwrotnej z rzeczywistych działań utrzymaniowych.
Dla producentów i innych organizacji intensywnie wykorzystujących zasoby techniczne predictive maintenance działa najlepiej wtedy, gdy koncentruje się na zasobach krytycznych, korzysta z rzeczywistych danych operacyjnych i jest wpisane w codzienne procesy utrzymania ruchu. Efektem nie jest tylko wcześniejsze wykrywanie awarii, ale także lepsza współpraca między produkcją, utrzymaniem ruchu, niezawodnością i zarządzaniem zasobami.
Tryb jasny